Generieren Sie robots.txt und eine URL-List Sitemap für eine kleine Site
Bereiten Sie Crawl-Regeln und Sitemap-XML vor, ohne Entdeckung, Indexierung und Zugriffskontrolle zu verwechseln.
Schreiben Sie das beabsichtigte öffentliche Inventar
Listen Sie kanonische Seiten auf, die für Besucher verfügbar sein sollten, und unterscheiden Sie sie von authentifizierten oder internen Routen. Der URL-Listengenerator crawlt die Website nicht oder entdeckt ihre Seiten. Verwenden Sie eine Export- oder eine überprüfte manuelle Liste und bewahren Sie sie mit den Starthinweisen auf. Eine Seite, die umleitet, einen Fehler zurückgibt oder noindex trägt, benötigt eine separate Überprüfung, bevor sie in eine indexierbare Sitemap gehört.
Erstellen Sie eine lesbare Robotergruppe
Das Robotergeneratorbeispiel setzt User-agent: *, allow /, disallows /admin/ und /internal/ und erklärt https://example.com/sitemap.xml. Es erzeugt eine Gruppe mit expliziten Pfaden. Veröffentlichen Sie die Datei unter /robots.txt auf dem beabsichtigten Schema, Host und Port. Die Pfadspezifität ist immer noch wichtig, so dass der Testvertreter Pfade mit dem vorhandenen Regeltester zugelassen und blockiert hat, bevor er sich auf die generierte Datei verlässt.
Erstellen Sie das zweiseitige Sitemap-Beispiel
Fügen Sie https://example.com/ und https://example.com/about/ in den URL-Listengenerator ein. Es erzeugt zwei URL-Einträge im Standard-Sitemap-Namespace. Duplizierte serialisierte URLs werden entfernt, Fragmente werden abgelehnt und diese Version erfordert einen Ursprung. Query-Amperands werden als XML entgangen, ohne die zugrunde liegende URL zu ändern. Lassen Sie den optionalen freigegebenen Lastmod leer, es sei denn, ein aussagekräftiges Seitenaktualisierungsdatum gilt wirklich für jede aufgeführte Seite.
| Wahlmöglichkeit | Hauptzweck | Begrenzung |
|---|---|---|
| robots.txt | Anweisungen für die Durchfahrt | Sichert oder deindexiert eine URL nicht zuverlässig |
| sitemap.xml | Canonische URL Entdeckung | Garantiert keine Crawling oder Indexierung |
| Authentifizierung | Zugang einschränken | Erfordert echte Server- oder Anwendungsdurchsetzung |
| noindex | Ausschluss von der Indexierung beantragen | Crawler muss die Anweisung lesen können |
Die Generatoren prüfen keine Live-Seiten oder konfigurieren den Server.
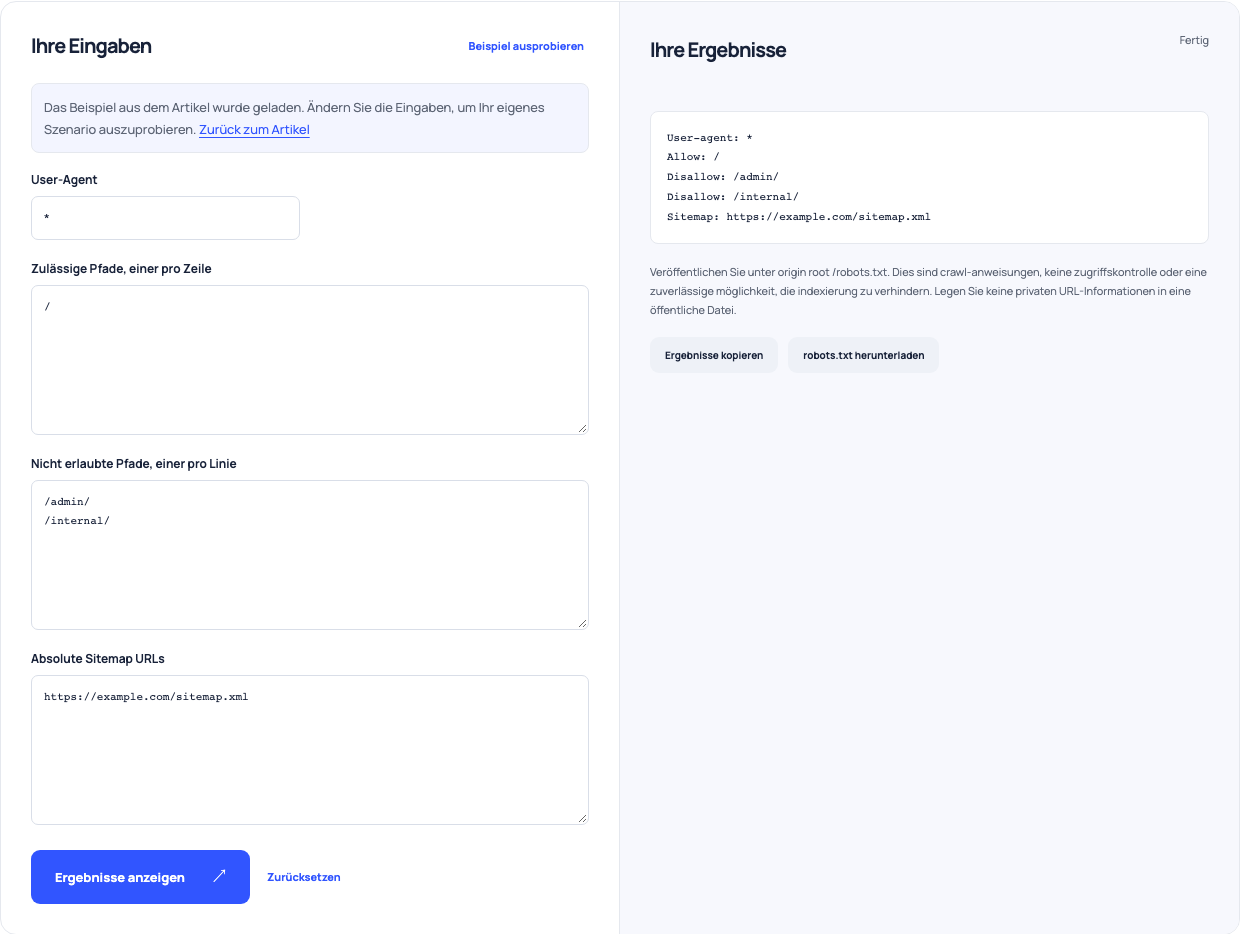
Verwenden Sie dieses Beispiel Öffnet Robots.txt mit diesen Eingaben.
Wählen Sie die richtige Kontrolle
Ein Roboter verbietet das Crawlen, nicht die Authentifizierung, und ein blockiertes URL kann weiterhin in der Suche aufgeführt werden. Eine Sitemap hilft bei der Entdeckung; sie überschreibt nicht die Crawl-Beschränkungen oder stellt die Indexierbarkeit her. Verwenden Sie Zugriffskontrollen für private Inhalte und eine geeignete noindex-Methode zur Indexierung von Entscheidungen. Legen Sie keine sensiblen Routeninformationen in eine öffentliche Roboterdatei unter der Annahme, dass die Datei sie verbirgt.
Überprüfen Sie die tatsächlich veröffentlichten Antworten
Laden Sie beide Dateien herunter, veröffentlichen Sie sie an den vorgesehenen Orten und rufen Sie genau diese URLs ab. Bestätigen Sie den Host, Sitemap-Links, Antwortinhalte und referenziertes Seitenverhalten. Testen Sie die Crawlregeln erneut mit der bereitgestellten Datei anstelle des Entwurfs. Wenn das URL-Inventar groß wird, verwenden Sie den vorhandenen Sitemap-Validator und Splitter, um veröffentlichte XML- und Protokollgrenzen zu überprüfen. Halten Sie Startabsicht und beobachtete Antworten als separate Beweise.