Gere robots.txt e um site URL-List para um site pequeno
Prepare regras de rastreamento e mapa do site XML sem confundir descoberta, indexação e controle de acesso.
Escreva o inventário público pretendido.
Listar páginas canônicas que devem estar disponíveis para visitantes e distingui-los de rotas autenticadas ou internas. O gerador da lista URL não rasteja o site ou descobre suas páginas. Use uma exportação ou uma lista manual revisada e mantenha com as notas de lançamento. Uma página que redireciona, retorna um erro ou carrega noindex precisa de uma revisão separada antes de pertencer a um mapa indexável.
Criar um grupo de robôs legíveis
O exemplo do gerador de robôs define usuário-agente: *, permite /, não permite /admin/ e /internal/, e declara https://example.com/sitemap.xml. Produz um grupo com caminhos explícitos. Publique o arquivo em /robots.txt no esquema pretendido, hospedeiro e porto. A especificidade do caminho ainda importa, então o representante do teste permitiu e bloqueou os caminhos com o verificador de regras existente antes de confiar no arquivo gerado.
Construa o exemplo do mapa de duas páginas.
Colar https://example.com/ e https://example.com/about/ para o URL- Gerador de lista. Produz dois. URL entradas no espaço padrão do mapa do site. URLs serializadas duplicadas são removidas, fragmentos são rejeitados e esta versão requer uma origem. Amendoins de busca são escapados como XML sem mudar a base URL. Deixe o último mod em branco opcional, a menos que uma data de atualização de página significativa se aplique a todas as páginas listadas.
| Escolha | Propósito primário. | Limite |
|---|---|---|
| robots.txt | Instruções de rastejo | Não é seguro ou confiável desindexar uma URL. |
| sitemap.xml | Descoberta de URL canônica | Não garante rastejar ou indexar |
| Autenticação | Restringir o acesso | Requer servidor real ou aplicação de aplicação |
| noindex | Solicito exclusão da indexação. | Crawler deve ser capaz de ler as instruções |
Os geradores não inspecionam páginas ao vivo ou configuram o servidor.
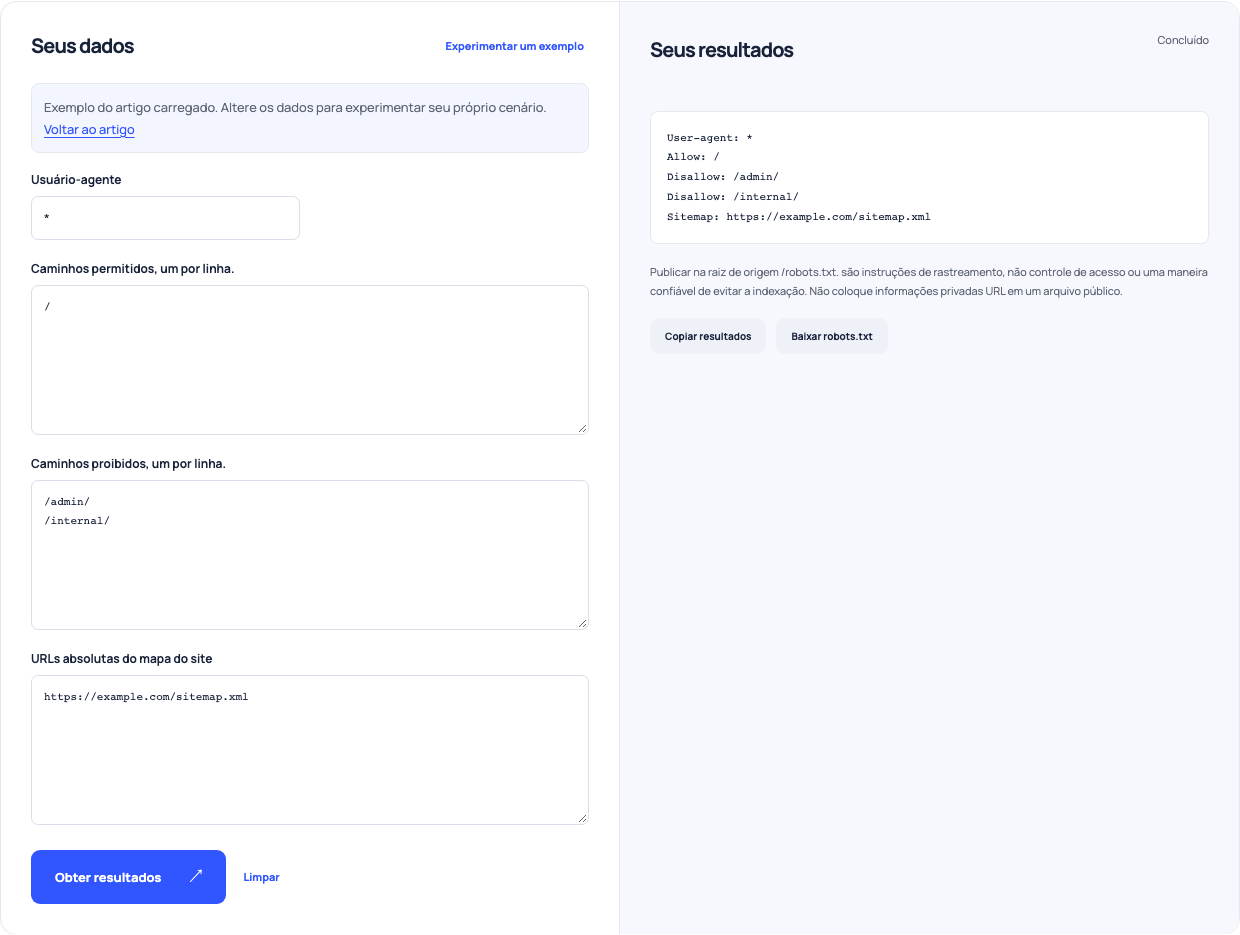
Use este exemplo. Abre Robots.txt com essas entradas.
Escolha o controle certo.
Um robô não permite o rastreamento de controles, não autenticação, e uma URL bloqueada ainda pode estar listada em busca. Um mapa do site ajuda a descobrir, não anula restrições de rastreamento ou estabelece indexação. Use controles de acesso para conteúdo privado e um método noindex adequado para indexar decisões. Não coloque informações confidenciais em um arquivo público de robôs sob a suposição de que o arquivo esconde.
Verifique as respostas publicadas.
Baixe os dois arquivos, publique nos locais pretendidos e recupere os URLs exatos. Confirme o host, links do mapa do site, conteúdo de resposta e o comportamento da página referenciada. Regras de rastreamento do representante de teste usando o arquivo implantado, ao invés do rascunho. Se o inventário de URL se tornar grande, use o validador e divisor de sites existente para revisar XML e protocolos publicados. Mantenha a intenção de lançamento e as respostas observadas como evidência separada.