Generar robots.txt y un sitio URL-lista para un sitio pequeño
Prepare reglas de rastreo y sitemap XML sin confundir descubrimiento, indexación y control de acceso.
Escriba el inventario público previsto
Listar páginas canónicas que deben estar disponibles para los visitantes y distinguirlas de rutas autenticadas o internas. El generador URL-lista no arrastra el sitio ni descubre sus páginas. Utilice una lista manual de exportación o una lista revisada y manténgalo con las notas de lanzamiento. Una página que redirige, devuelve un error o lleva noindex necesita una revisión separada antes de pertenecer a un mapa de sitio indigno.
Crear un grupo de robots legibles
El ejemplo del generador de robots establece: *, permite /, desactiva /admin/ y /internal/, y declara https://example.com/sitemap.xml. Produce un grupo con caminos explícitos. Publique el archivo en /robots.txt en el esquema previsto, host y puerto. La especificidad del camino sigue siendo importante, por lo que el representante de la prueba permitió y bloqueó caminos con el probador de reglas existente antes de confiar en el archivo generado.
Construir el ejemplo de mapa web de dos páginas
Paste https://example.com/ y https://example.com/about/ en el generador URL-lista. Produce dos entradas de URL en el espacio de nombres de mapa de sitio estándar. Se eliminan URLs serializadas duplicadas, se rechazan fragmentos y esta versión requiere un origen. Los ampersands de consulta se escapan como XML sin cambiar la URL subyacente. Deje el últimomod opcional compartido en blanco a menos que una fecha de actualización de página significativa se aplique genuinamente a cada página lista.
| Elección | Objetivo primario | Limit |
|---|---|---|
| robots.txt | Instrucciones de Crawl | No asegura ni desindienta fiable una URL |
| sitemap.xml | Búsqueda de URL canónica | No garantiza arrastre o indexación |
| Autenticación | Acceso restringido | Requiere servidor real o aplicación |
| noindex | Solicitud de exclusión de la indexación | Crawler debe ser capaz de leer la instrucción |
Los generadores no inspeccionan las páginas en vivo o configuran el servidor.
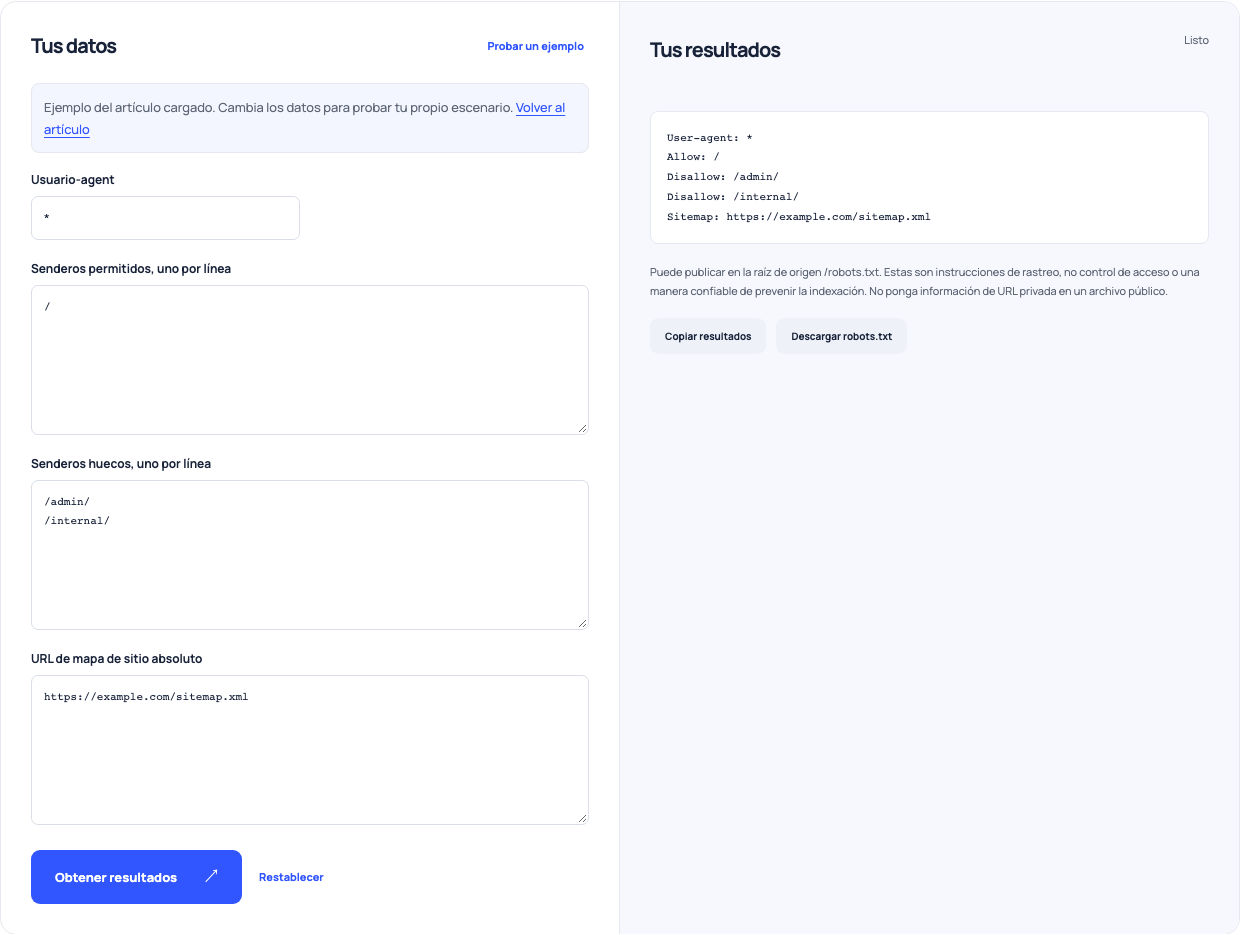
Use este ejemplo Abre Robots.txt con estas entradas.
Elija el control correcto
Un robots desactiva los controles arrastrando, no la autenticación, y una URL bloqueada todavía puede ser listado en la búsqueda. Un mapa de sitio ayuda al descubrimiento; no anula las restricciones de los arrastres o establece la indexabilidad. Use controles de acceso para contenido privado y un método noindex adecuado para las decisiones de indexación. No ponga información de ruta sensible en un archivo de robots públicos bajo la suposición de que el archivo lo oculta.
Revisar las respuestas publicadas
Descargar ambos archivos, publicarlos en los lugares previstos y recuperar las URL exactas. Confirme el host, enlaces de mapa de sitio, contenido de respuesta y comportamiento de página referenciado. El representante de prueba arrastra de nuevo las reglas usando el archivo desplegado, en lugar del proyecto. Si URL inventario se hace grande, utilizar el validador de mapas de sitio existente y separador para revisar publicado XML y los límites del protocolo. Mantenga la intención de lanzamiento y observe respuestas como pruebas separadas.