Générer des robots.txt et une URL-List Plan du site pour un petit site
Préparer les règles de crawl et sitemap XML sans confondre découverte, indexage et contrôle d'accès.
Écrire l'inventaire public prévu
Lister les pages canoniques qui devraient être disponibles pour les visiteurs et les distinguer des itinéraires authentifiés ou internes. Le générateur de liste URL ne rampe pas le site ou ne découvre pas ses pages. Utilisez une liste d'exportation ou une liste manuelle révisée et conservez-la avec les notes de lancement. Une page qui redirige, retourne une erreur ou transporte noindex a besoin d'un examen séparé avant qu'elle ne fasse partie d'un plan de site indexé.
Créer un groupe de robots lisibles
L'exemple du générateur de robots définit User-agent: *, permet /, interdit /admin/ et /internal/, et déclare https://example.com/sitemap.xml. Il produit un groupe avec des chemins explicites. Publier le fichier à /robots.txt sur le schéma, l'hôte et le port prévus. La spécificité du chemin est toujours importante, de sorte que le représentant du test a permis et bloqué les chemins avec le testeur de règles existant avant de se fier au fichier généré.
Construisez l'exemple du plan du site de deux pages
Coller https://example.com/ et https://example.com/about/ dans le générateur URL-list. Il produit deux entrées d'URL dans l'espace de nom standard du sitemap. Les URLs sérialisées dupliquées sont supprimées, les fragments sont rejetés et cette version nécessite une origine. Les ampersands de requêtes sont échappés en XML sans changer l'URL sous-jacente. Laissez l'option partagée en blanc pour la dernièremod à moins qu'une date de mise à jour significative de page ne s'applique réellement à chaque page listée.
| Choix | Objectif principal | Limite |
|---|---|---|
| robots.txt | Instructions pour le décapage | Ne protège pas ou ne désindexe pas de manière fiable une URL |
| sitemap.xml | Découverte d'URL canonique | Ne garantit pas le rampage ou l'indexation |
| Authentification | Restreindre l'accès | Nécessite un serveur réel ou une application |
| noindex | Demander l'exclusion de l'indexation | Crawler doit pouvoir lire les instructions |
Les générateurs n'inspectent pas les pages en direct ni ne configurent le serveur.
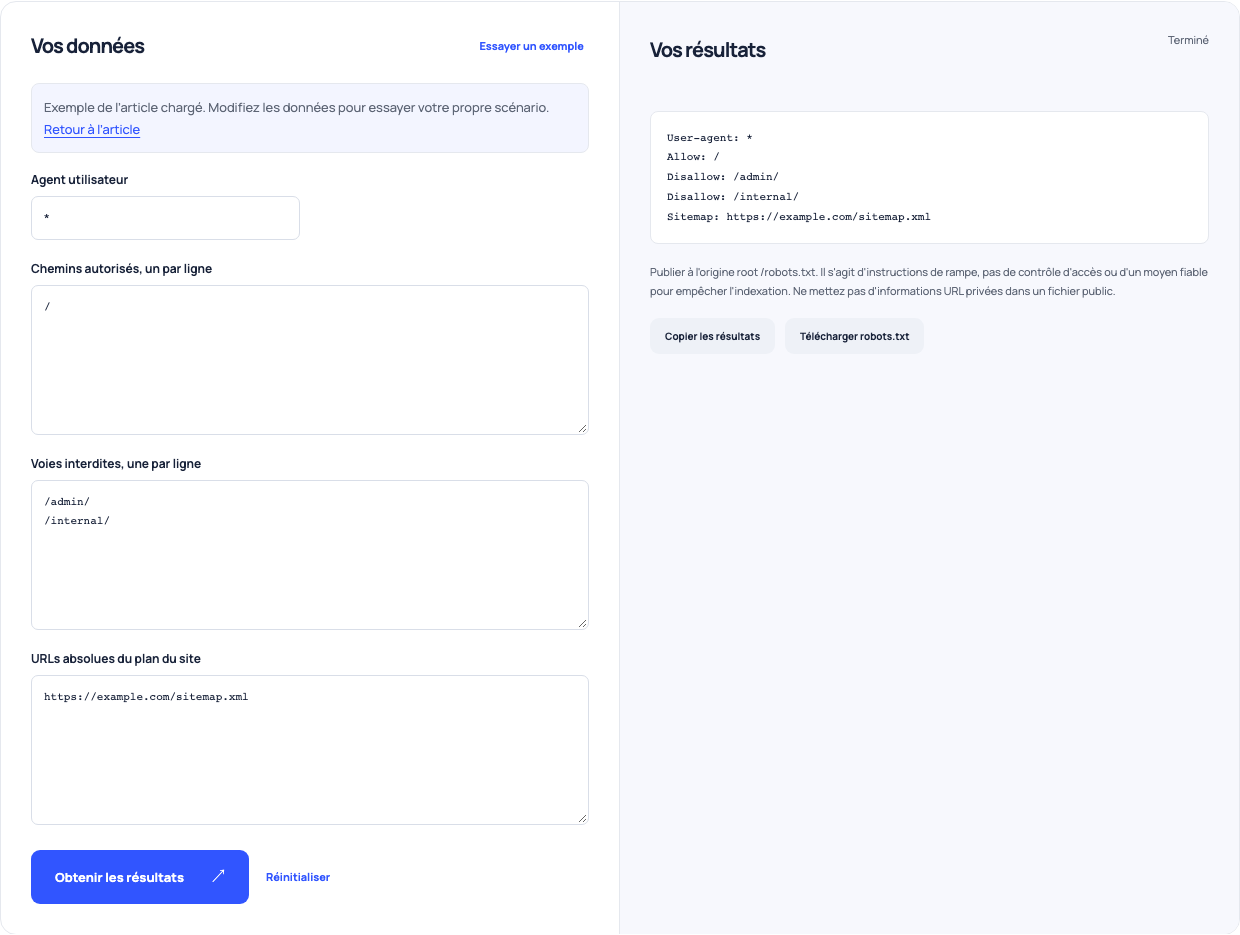
Utilisez cet exemple Ouvre Robots.txt avec ces entrées.
Choisissez le bon contrôle
Un robot interdit les contrôles rampants, pas l'authentification, et une URL bloquée peut encore être listée dans la recherche. Un plan du site aide à la découverte; il ne remplace pas les restrictions de rampement ni n'établit l'indexation. Utiliser des contrôles d'accès pour le contenu privé et une méthode noindex appropriée pour l'indexation des décisions. Ne mettez pas d'informations sensibles sur l'itinéraire dans un fichier de robots publics en supposant que le fichier le cache.
Vérifier les réponses réelles publiées
Télécharger les deux fichiers, les publier dans les emplacements prévus et récupérer ces URL exactes. Confirmez l'hôte, les liens du sitemap, le contenu de la réponse et le comportement de la page référencée. Tester les règles de rampe représentant à nouveau en utilisant le fichier déployé, plutôt que l'ébauche. Si URL l'inventaire devient important, utiliser le validateur de plan de site existant et le séparateur pour examiner publié XML et les limites du protocole. Conservez l'intention de lancement et observez les réponses comme des preuves distinctes.