Markdown Preview, doppelte Zeilen und Unicode Text Counts
Zeigen Sie einen Entwurf an, reinigen Sie exakt wiederholte Linien und wählen Sie das Zeichenmaß, das zum Ziel passt.
Schreiben und Aufräumen von Aufgaben trennen
Speichern Sie den Originalentwurf, bevor Sie wiederholte Zeilen entfernen oder das Markup ändern. Das Duplicate-Line-Tool vergleicht ganze Textzeilen, nicht analysierte CSV-Datensätze oder semantische Ideen. Der Markdown-Konverter stellt einen unterstützten Dialekt dar, während das Statistik-Tool den gelieferten Text misst. Verwenden Sie jedes für seine eigene Frage, damit eine Bereinigung nicht versehentlich eine wiederholte Linie entfernt, die einem absichtlichen strukturellen Zweck dient.
Vorschau auf den gelieferten Markdown
Das Beispiel enthält eine Überschrift, einen Absatz mit fetter Betonung und eine Zwei-Punkte-Liste. Der Konverter erzeugt HTML und eine Sandbox-Vorschau, ohne eingefügtes Roh-HTML auszuführen. Rohes HTML wird sichtbarer Text, Bilder werden weggelassen und unsichere Linkschemata werden entfernt. Tabellen mit GitHub-Aroma und Syntax der gemeinsamen Liste werden unterstützt, aber ein anderes CMS kann einen anderen Markdown-Dialekt interpretieren. Überprüfen Sie das heruntergeladene HTML an seinem tatsächlichen Zielort.
Entfernen Sie nur die Duplikate, die Sie meinen
Das Line-Cleanup-Beispiel enthält Apple zweimal, Bananen einmal und eine kleine Bananenvariante. Genauer fallsensitiver Vergleich entfernt nur den wiederholten Apple. Die Wahl Ignorieren Fall und Trim behält die ersten ursprünglichen Apple und Banana Linien und behandelt die beabstandete Kleinbuchstaben-Variante als Duplikat. Diese Optionen ändern den Vergleichsschlüssel, nicht die Schreibweise oder den Weißraum der ersten beibehaltenen Zeile. Die Ordnung bleibt erhalten.
| Aufgabe | Beispiel | Bedeutung |
|---|---|---|
| Genaue doppelte Zeilen | Wiederholtes Apple entfernt | Behält das erste Originalereignis bei |
| Trimmen und ignorieren Fall | Bananen und gestreute Bananen | Vergleichsänderungen, beibehaltener Text nicht |
| UTF-16 zählen für 🙂 | 2 | JavaScript-Stringcode-Einheiten |
| Codepoint Count für 🙂 | 1 | Unicode-Skalarzahl |
| Grapheme zählen für 🙂 | 1 | Sichtbare Clusterzahl |
Wortschätzungen verwenden Whitespace und sind nicht für jedes Schreibsystem geeignet.
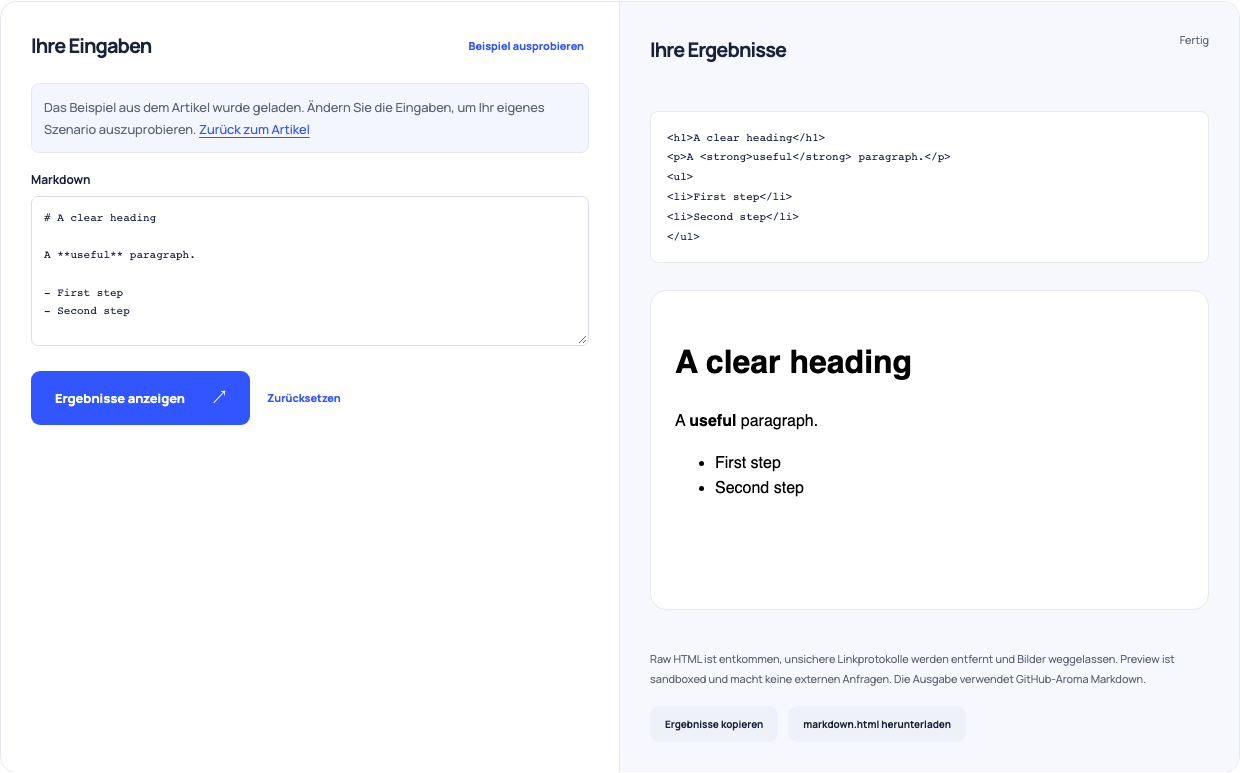
Verwenden Sie dieses Beispiel Öffnet Markdown zu HTML mit diesen Eingaben.
Zählen Sie die Einheit, die das Ziel tatsächlich verwendet
Das Statistik-Tool zählt UTF-16-Codeeinheiten, Unicode-Codepunkte und Graphem-Cluster separat. Ein einzelnes 🙂 hat zwei UTF-16-Codeeinheiten, einen Codepunkt und einen sichtbaren Graphem. Ein verbundenes Familien-Emoji kann mehrere Codepunkte, aber ein Graphem enthalten. Wörter sind weißraumbegrenzte Brocken, daher ist diese Methode ungefähr für Sprachen ohne Leerzeichen. Die zweizeilige Prosa des Beispiels hat sechs solcher Wörter; Die Lesezeit teilt sich durch das von Ihnen gewählte Tempo.
Überprüfen Sie den endgültigen Text, wo er erscheinen wird
Vergleichen Sie nach der Bereinigung sinnvolle wiederholte Etiketten mit dem Original und überprüfen Sie gerenderte Überschriften, Listen und Links. Wählen Sie die vom Verlagssystem benötigte Zeichenmetrik, anstatt jeden Zähler als austauschbar zu behandeln. Das Lesen von Schätzungen lässt Pausen und Verständnis aus. Eine ordentliche markup-vorschau und eine kurze wortzahl können helfen, zu bearbeiten, aber keiner beweist, dass anweisungen für den beabsichtigten leser korrekt, vollständig oder verständlich sind.