Visualização de marcação, linhas duplicadas e contagem de texto Unicode
Visualize um rascunho, limpe linhas exatas e escolha a medida de caráter que se encaixa no destino.
Continue escrevendo e limpando tarefas separadas.
Salve o rascunho original antes de remover linhas repetidas ou mudar de marcação. A ferramenta duplicada compara linhas de texto inteiras, não registros CSV analisados ou idéias semânticas. O conversor Markdown renderiza um dialeto suportado, enquanto a ferramenta estatística mede o texto fornecido. Use cada um para sua própria pergunta para que uma limpeza não acidentalmente remova uma linha repetida que sirva a um propósito estrutural deliberado.
Visualize o Markdown fornecido.
O exemplo contém um cabeçalho, um parágrafo com ênfase ousada e uma lista de dois itens. O conversor produz HTML e uma pré-visualização sem executar HTML cru colado. HTML cru torna-se texto visível, imagens são omitidas e esquemas de links inseguros são removidos. Mesas com sabor de GitHub e sintaxe de lista comum são suportadas, mas outro CMS pode interpretar um dialeto Markdown diferente. Inspecione o HTML baixado em seu destino.
Remova apenas as duplicatas que você quer dizer
O exemplo de limpeza inclui Apple duas vezes, Banana uma vez e uma variante de banana espaçada. A comparação exata remove apenas a Apple repetida. Escolhendo o caso Ignore e Trim mantém as primeiras linhas originais de Apple e Banana e trata a variante espaçada como uma duplicata. Essas escolhas mudam a chave de comparação, não a ortografia ou espaço em branco da primeira linha retida. A ordem está preservada.
| Tarefa | Exemplo | Significando |
|---|---|---|
| Linhas duplicadas exatas | Maçã repetida removida. | Mantém a primeira ocorrência original. |
| Aparar e ignorar o caso | Banana e banana espaçada | A comparação muda, texto retido não |
| UTF-16 conta para | 2 | Unidades de código JavaScript string |
| Contagem de pontos de código para | 1 | Contagem escalar Unicode |
| Contagem de grafemas para | 1 | Contagem visível de aglomerados |
Estimativas de palavras usam espaço em branco e não são apropriadas para cada sistema de escrita.
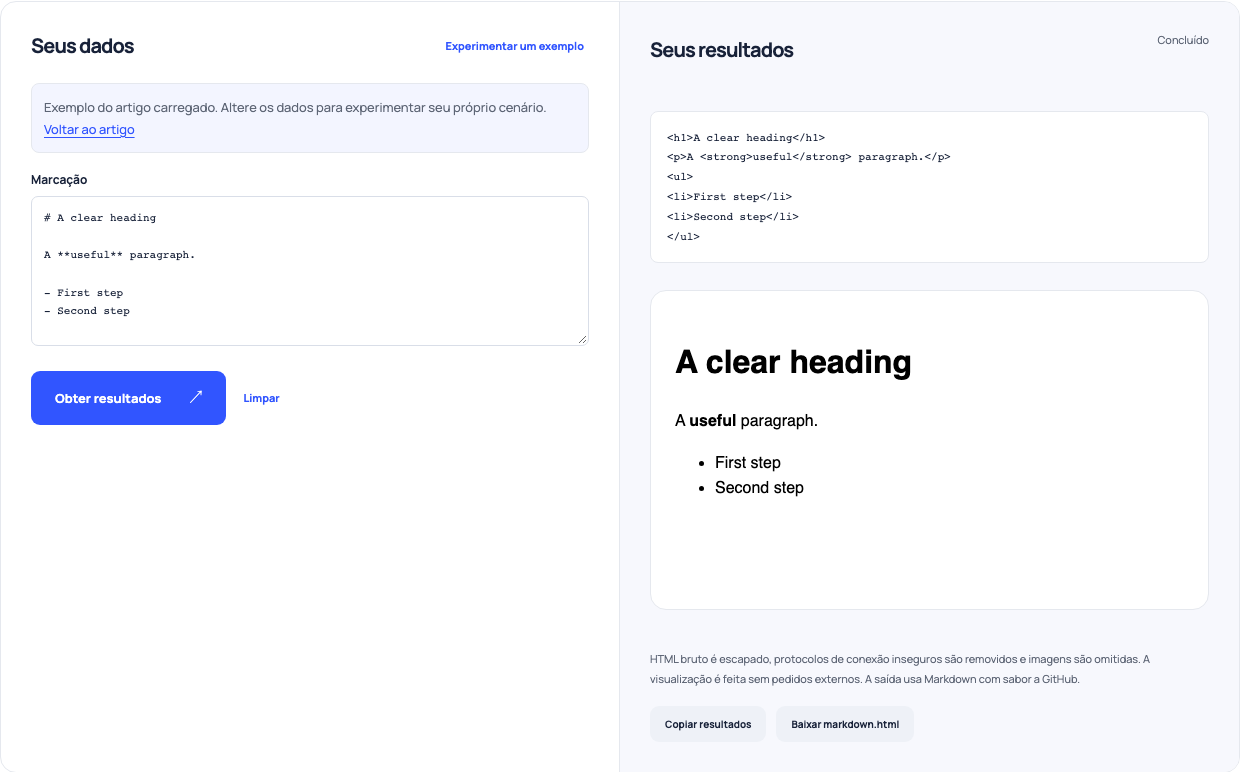
Use este exemplo. Abre Markdown para HTML com essas entradas.
Conte a unidade que o destino realmente usa.
A ferramenta estatística conta separadamente unidades de código UTF-16, pontos de código Unicode e grupos de grafemas. Um único tem duas unidades de código UTF-16, um ponto de código e um grafema visível. Um emoji da família unida pode conter vários pontos de código mas um grafema. Palavras são partes delimitadas por espaços em branco, então este método é aproximado para linguagens sem espaços. A prosa de duas linhas do exemplo tem seis palavras, o tempo de leitura divide que contam pelo seu ritmo escolhido.
Verifique o texto final onde ele aparecerá.
Após a limpeza, compare etiquetas repetidas significativas com o original e verifique títulos renderizados, listas e links. Escolha a métrica de caráter exigida pelo sistema editorial em vez de tratar cada contador como intercambiável. As estimativas de leitura omitem pausas e compreensão. Uma previsão de marcação e uma pequena contagem de palavras podem ajudar a editar, mas nenhuma prova que as instruções são precisas, completas ou compreensíveis para o leitor.