Aperçu du balisage, lignes dupliquées et nombres de textes Unicode
Prévisualiser une ébauche, nettoyer les lignes répétées exactes et choisir la mesure de caractère qui correspond à la destination.
Gardez les tâches d'écriture et de nettoyage séparées
Enregistrez l'ébauche originale avant de supprimer les lignes répétées ou de modifier le balisage. L'outil double-ligne compare des lignes de texte entières, pas des enregistrements CSV parsés ou des idées sémantiques. Le convertisseur Markdown rend un dialecte supporté, tandis que l'outil statistique mesure le texte fourni. Utilisez chacun pour sa propre question de sorte qu'un nettoyage ne supprime pas accidentellement une ligne répétée qui sert un but structural délibéré.
Aperçu du Markdown fourni
L'exemple contient un titre, un paragraphe avec un accent gras et une liste de deux points. Le convertisseur produit du HTML et un aperçu sandbox sans exécuter de HTML brut collé. Le HTML brut devient du texte visible, les images sont omises et les schémas de liens dangereux sont supprimés. Les tables GitHub et la syntaxe de liste commune sont prises en charge, mais un autre CMS peut interpréter un dialecte Markdown différent. Inspectez le HTML téléchargé dans sa destination réelle.
Enlever seulement les duplicata que vous voulez dire
L'exemple de nettoyage de ligne inclut Apple deux fois, Banana une fois et une variante de banane minuscule espacée. Une comparaison exacte et sensible ne supprime que l'Apple répétée. Choisir le boîtier Ignore et Trim conserve les premières lignes originales Apple et Banana et traite la variante en minuscules espacées comme un duplicata. Ces choix changent la clé de comparaison, et non l'orthographe ou l'espace blanc de la première ligne retenue. L'ordre est préservé.
| Tâche | Exemple | Signification |
|---|---|---|
| Lignes dupliquées exactes | Pomme répétée enlevée | Contient la première occurrence originale |
| Trim et ignorer le cas | La banane et la banane espacées fusionnent | Les changements de comparaison, le texte retenu ne |
| UTF-16 compte pour . | 2 | Unités de code de chaîne JavaScript |
| Nombre de points de code pour le chiffre | 1 | Nombre de scalaires Unicode |
| Nombre de graphiques pour l'année | 1 | Nombre de grappes visibles |
Les estimations de mots utilisent l'espace blanc et ne sont pas appropriées pour chaque système d'écriture.
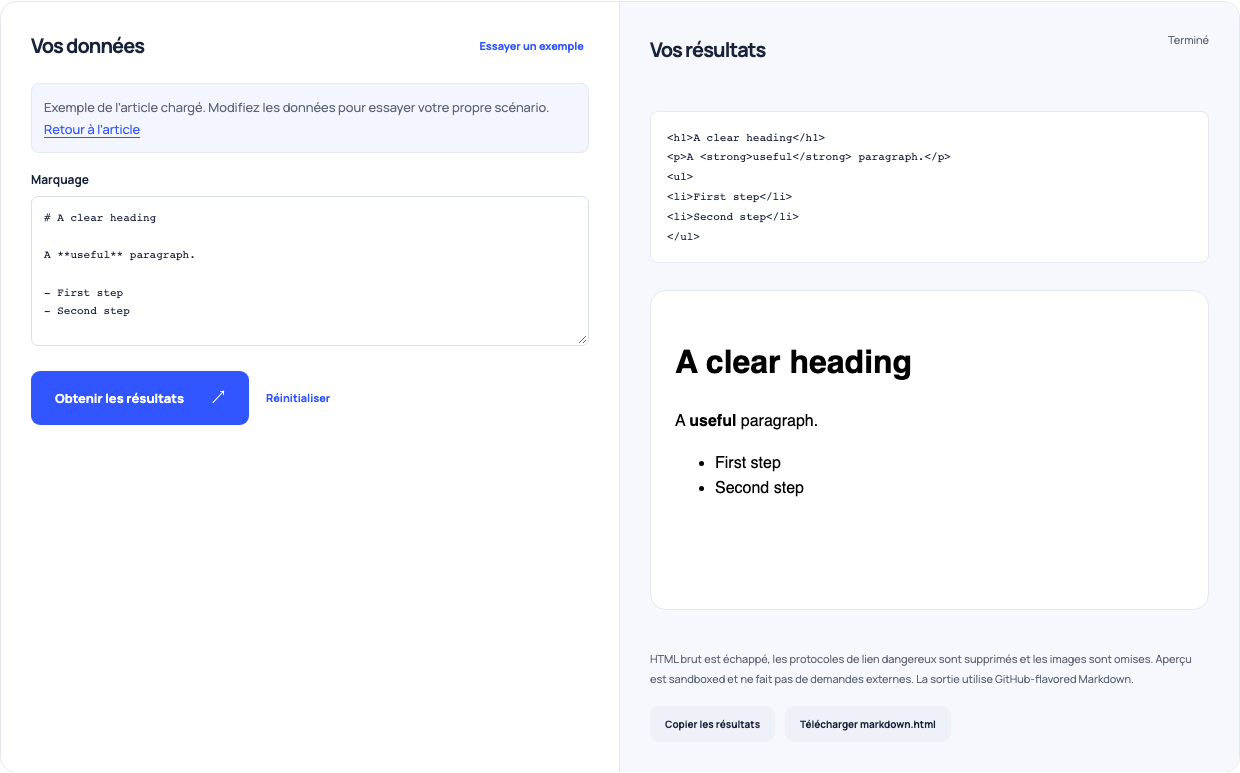
Utilisez cet exemple Ouvre Markdown au HTML avec ces entrées.
Compter l'unité utilisée par la destination
L'outil statistique compte séparément les unités de code UTF-16, les points de code Unicode et les groupes graphiques. Une seule unité de code UTF-16, un point de code et un graphique visible. Un émoji de famille rejoint peut contenir plusieurs points de code mais un graphique. Les mots sont des morceaux délimités par l'espace blanc, donc cette méthode est approximative pour les langues sans espaces. L'exemple de la prose à deux lignes a six tels mots; le temps de lecture divise qui comptent selon votre rythme choisi.
Vérifier le texte final où il apparaîtra
Après nettoyage, comparez les étiquettes répétées significatives avec les rubriques, listes et liens originaux et vérifiés. Choisissez la métrique de caractères requise par le système d'édition au lieu de traiter chaque compteur comme interchangeable. Les estimations de lecture omettent les pauses et la compréhension. Un aperçu de balisage rangé et un compte de mot court peuvent aider à l'édition, mais ni l'un ni l'autre ne prouve que les instructions sont exactes, complètes ou compréhensibles pour le lecteur prévu.